Corrección de Errores Cuánticos: Guía y Códigos de Superficie
La corrección de errores cuánticos (QEC, por sus siglas en inglés) es un marco algorítmico diseñado para blindar la información cuántica frente al ruido ambiental y los fallos del hardware. Dado que el teorema de no clonación y el colapso de la función de onda impiden copiar o medir los estados directamente, la QEC entrelaza un estado cuántico arbitrario en un conjunto de cúbits físicos para dar lugar a un único cúbit lógico de alta resiliencia, diagnosticando las perturbaciones mediante mediciones de síndrome no destructivas.
Un ordenador cuántico no falla de la misma manera que lo hace un ordenador clásico. En la informática tradicional, un bit está concebido para asentarse en uno de dos estados bien definidos: 0 o 1. Un cúbit, en cambio, puede habitar una superposición coherente, adquirir una fase relativa y entrelazarse con otros cúbits. Estas propiedades otorgan a la computación cuántica su enorme potencia teórica, pero al mismo tiempo vuelven a la información sumamente vulnerable a cualquier fluctuación mínima en el hardware o en el entorno.
Este es el desafío fundamental que aborda la corrección de errores cuánticos. El objetivo no radica en construir un cúbit físico impoluto e inmune a las perturbaciones, sino en dispersar un estado cuántico frágil a lo largo de múltiples cúbits físicos. De este modo, los fallos pueden detectarse, aislarse y corregirse sin necesidad de medir directamente la información cuántica que se intenta proteger.
Comprender este matiz resulta crucial: la computación cuántica práctica y comercial jamás dependerá únicamente de apilar más cúbits físicos. La máquina debe ser capaz de transformar cúbits físicos propensos al error en cúbits lógicos fiables y robustos. Este paso constituye el mayor cuello de botella y el problema de ingeniería determinante para alcanzar la tolerancia a fallos.
Por qué los ordenadores cuánticos son tan extremadamente frágiles
La información cuántica subsiste en un equilibrio físico extraordinariamente precario. Un cúbit superconductor, por ejemplo, puede desestabilizarse por fluctuaciones electromagnéticas, pulsos de control defectuosos, fugas hacia niveles energéticos espurios, efectos térmicos, diafonía (crosstalk) e imperfecciones microscópicas en los materiales del chip. Los iones atrapados y los átomos neutros sufren mecanismos de error diferentes, pero el origen del problema no varía: ningún sistema físico puede aislarse por completo de su entorno.
La coherencia cuántica es el elemento más vulnerable de la ecuación. La utilidad de un estado cuántico no se apoya solo en la probabilidad de medir 0 o 1, sino en la relación de fase que mantienen los componentes de la superposición. Cualquier interacción imprevista con el entorno filtra de manera progresiva la información del estado hacia grados de libertad ajenos a nuestro control. Este fenómeno físico destructivo se denomina decoherencia.
Entender por qué esto se vuelve devastador en un cálculo real resulta bastante evidente. Imaginemos que una puerta lógica física tiene una probabilidad ínfima de introducir un error. Al encadenar un circuito con miles o millones de operaciones, esas pequeñas desviaciones se van acumulando sin freno. Si incrementamos la profundidad del circuito sin reducir de forma paralela la tasa de error intrínseca, el cálculo coherente no tarda en degradarse por completo en mero ruido térmico.
Por ello, la corrección de errores cuánticos no es una optimización menor que pueda dejarse para cuando los ordenadores cuánticos crezcan de tamaño; es el principio físico operativo que hace posibles los cómputos de larga duración.
Por qué fallan los métodos clásicos de corrección de errores
La corrección de errores en la informática clásica recurre a una premisa muy sencilla: si un dato es crítico, se replica varias veces. Se guarda «000» para un 0 lógico y «111» para un 1 lógico. Si una de las celdas de memoria experimenta un fallo fortuito y cambia de estado, basta con recurrir a una votación por mayoría simple para reconstruir la información original.
En un estado cuántico arbitrario y desconocido, sin embargo, replicar este método resulta físicamente imposible.
El obstáculo fundamental estriba en el teorema de no clonación. Las leyes de la mecánica cuántica prohíben una operación unitaria universal capaz de tomar un estado cuántico desconocido |ψ⟩ y devolver dos copias independientes idénticas, |ψ⟩|ψ⟩. Esta limitación no se debe a la falta de madurez de los componentes actuales; es una propiedad inmutable derivada de la linealidad de la teoría cuántica.
Pensemos en un estado cuántico desconocido como una pompa de jabón cuya superficie contiene los datos que necesitamos conservar. Resulta imposible fotografiar esa pompa a la perfección, imprimirla y generar una segunda pompa gemela sin extraer una información que la física prohíbe obtener. Se trata de una barrera conceptual, no de un defecto técnico.
La medición directa impone un segundo escollo insalvable. Medir un cúbit desconocido en la base computacional nos revela si el desenlace es 0 o 1, pero destruye al instante cualquier superposición arbitraria como |ψ⟩ = α|0⟩ + β|1⟩. El propio acto de medir fuerza el colapso del estado sobre uno de los autoestados de la base de medida.
La conclusión es clara: la estrategia clásica fracasa por partida doble. No podemos duplicar el estado original y tampoco podemos inspeccionar el cúbit para averiguar si ha fallado sin arruinar irremediablemente la información que queríamos resguardar.
La corrección de errores cuánticos esquiva esta paradoja codificando la información en un estado entrelazado de mayor dimensión. Así, no nos preguntamos «¿cuál es el estado exacto de nuestro cúbit lógico?», sino una cuestión mucho más restringida e indirecta: «¿qué patrón de error acaba de producirse?».
Cómo funciona la corrección de errores cuánticos sin «mirar»
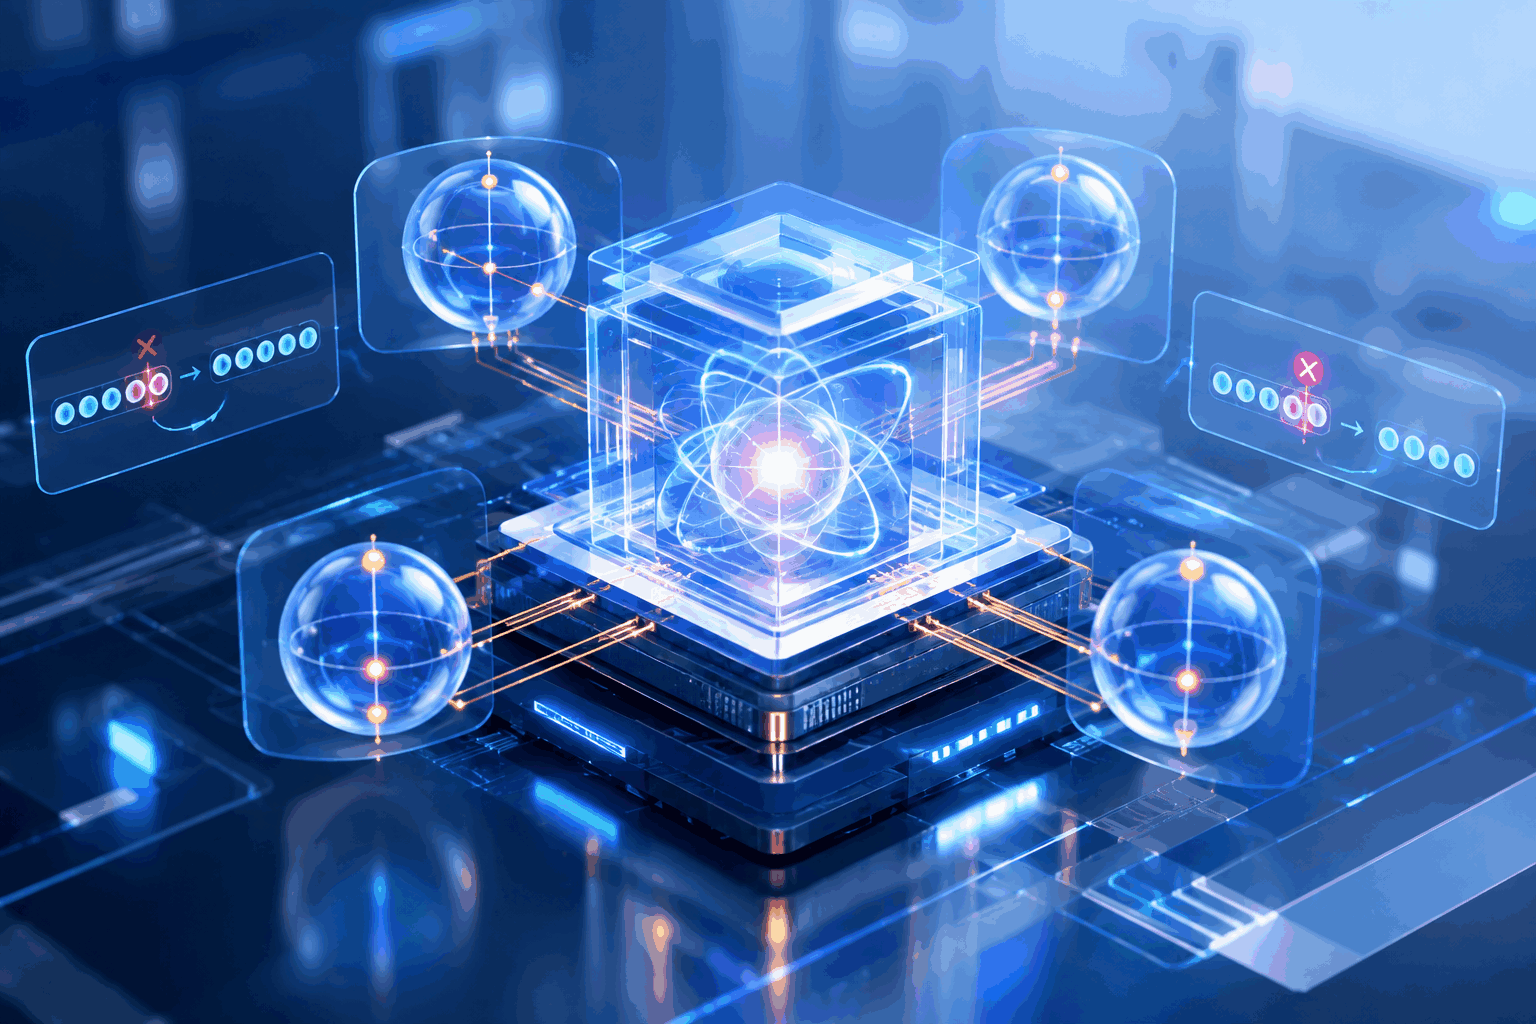
El pilar fundamental de este proceso es el síndrome de error. Un síndrome proporciona datos exclusivos sobre las perturbaciones que afectan a un estado codificado, evitando deliberadamente filtrar información sobre el propio estado lógico subyacente.
Para comprender el mecanismo, conviene desglosar los dos fallos elementales descritos por las matrices de Pauli: el error X (la inversión clásica de bit) y el error Z (la inversión de fase).
Un error X transforma |0⟩ en |1⟩ y |1⟩ en |0⟩. En cambio, un error Z actúa de forma más sutil: no altera |0⟩, pero introduce un signo negativo frente a |1⟩. Aunque este signo pueda parecer inocuo en un cúbit aislado, en una superposición cuántica la fase relativa gobierna las interferencias constructivas y destructivas. En consecuencia, un simple desfase altera el resultado de un algoritmo entero.
He aquí el motivo por el cual la corrección de errores cuánticos no puede implementarse como un simple código de repetición clásico adaptado a hardware cuántico: la arquitectura debe blindar la información frente a inversiones de bit y de fase simultáneamente.
La solución consiste en incorporar cúbits auxiliares (ancillas). Estos cúbits extra interactúan con los cúbits de datos mediante puertas lógicas minuciosamente dispuestas. Tras el entrelazamiento, se miden únicamente los cúbits ancilla en lugar de los cúbits lógicos de datos. El desenlace de esa medición extrae la paridad del sistema, revelando la presencia de fallos sin violar la superposición.
Una analogía útil es la de una caja de cambios hermética. No abrimos la carcasa para inspeccionar los engranajes mientras gira. En su lugar, colocamos acelerómetros externos en el chasis para registrar patrones de vibración anómalos. Las frecuencias indican si un engranaje patina, pero no desvelan la posición exacta de cada diente en tiempo real.
La medición de síndromes opera bajo esa misma lógica. Las comprobaciones de estabilizadores notifican al decodificador si el patrón de desviaciones encaja con una situación «sin error», un error de tipo X, un error de tipo Z o una combinación de ambos. Mientras tanto, el estado cuántico protegido permanece resguardado a lo largo de todo el ciclo.
| Característica | Corrección de errores clásica | Corrección de errores cuánticos |
|---|---|---|
| Redundancia | Copias directas o bits de paridad adicionales replican el dato de origen. | La información cuántica se distribuye y entrelaza entre múltiples cúbits físicos. |
| Capacidad de clonación | Permite duplicar cualquier bit clásico tantas veces como sea necesario. | No permite clonar un estado cuántico arbitrario debido al teorema de no clonación. |
| Tipología de errores | Habitualmente modelados como inversiones de bits (0 a 1 o viceversa) o pérdidas de paquetes. | Debe subsanar inversiones de bit (X), inversiones de fase (Z) y combinaciones simultáneas de ambas (Y). |
| Proceso de medición | Comprobar el valor de un bit no altera su contenido digital. | La medición directa de un estado desconocido colapsa la función de onda y destruye la superposición. |
| Detección del fallo | Comprobaciones de paridad directa revelan discrepancias en los bits duplicados. | Mediciones de síndromes mediante cúbits auxiliares (ancillas) extraen paridad sin perturbar el dato lógico. |
| Elemento protegido | Un bit clásico o un bloque de bytes. | Un cúbit lógico distribuido a través de una matriz de cúbits físicos. |
| Papel del decodificador | Identifica la secuencia binaria más probable tras la transmisión. | Reconstruye el patrón de error físico más probable a partir de lecturas de síndrome ruidosas. |
| Meta fundamental | Restablecer con exactitud el valor discreto original (0 o 1). | Preservar la coherencia cuántica y ejecutar compuertas mientras se neutraliza la propagación de fallos lógicos. |
En los procesadores reales, el problema se complica notablemente debido a que las propias mediciones del síndrome arrastran su propio margen de error. Por tanto, el decodificador no procesa datos deterministas e inmaculados, sino series temporales estocásticas con fallos instrumentales. En la actualidad, la decodificación de códigos de superficie se aborda como un reto de ingeniería de sistemas complejo, apoyado en hardware clásico especializado, cómputo en tiempo real y algoritmos de grafos de alto rendimiento.
Códigos de superficie: la gran apuesta de la industria cuántica
Entre la amplia variedad de arquitecturas teóricas existentes, los códigos de superficie se han erigido en la vía preferente para cúbits superconductores y otros sistemas basados en interacciones locales en dos dimensiones.
Su planteamiento se fundamenta en una distribución geométrica. Los cúbits se organizan en una cuadrícula bidimensional en la que los cúbits de datos se intercalan con cúbits auxiliares de medición encargados de evaluar de forma periódica las restricciones de estabilizador. En vez de almacenar un cúbit lógico en una ubicación física aislada, la información se distribuye como una propiedad colectiva y topológica de toda la malla.
El factor de referencia en este esquema es la distancia del código, representada por la variable d. A grandes rasgos, cuanto mayor sea la distancia, más fallos físicos simultáneos deberán acumularse para que se deslice un error lógico no detectable. En un retículo de código de superficie, esta distancia equivale a la cadena no trivial más corta de operadores lógicos que enlaza extremos opuestos de la cuadrícula.
Si un cúbit físico individual sufre un error de tipo X, los estabilizadores adyacentes registran de inmediato una firma característica de cambios en el síndrome. El algoritmo decodificador analiza estos eventos de detección y calcula la posición donde con mayor probabilidad tuvo lugar el fallo. Mientras los errores se mantengan dispersos, el decodificador aplica una corrección matemática antes de que la perturbación llegue a corromper el cómputo global.
No obstante, existe una condición ineludible: el umbral.
Por debajo del umbral de tolerancia a fallos, elevar la distancia del código reduce la tasa de error lógico de forma exponencial. Si se opera por encima de este umbral, añadir cúbits no sirve de nada: la inclusión de hardware adicional genera más fuentes de ruido de las que el código es capaz de compensar mediante la redundancia.
El límite habitual del «1 %» suele citarse como referencia orientativa, no como una constante absoluta e inmutable. El umbral real en un chip operativo depende del tipo de código, los patrones de ruido físico, las fugas de niveles energéticos, la conectividad, la latencia de las compuertas, el circuito de lectura y la presencia de errores correlacionados. En los procesadores reales, la clave es que la totalidad del ciclo de cálculo —puertas, lecturas, reinicios y decodificación— se sitúe por debajo de dicho umbral operativo.
Cúbits físicos frente a cúbits lógicos
Este punto marca la frontera exacta donde la teoría matemática choca de lleno con las dificultades de la ingeniería.
Un cúbit físico es un dispositivo de hardware tangible: una unión Josephson en un circuito superconductor, un ion atrapado por campos electromagnéticos, un átomo neutro en pinzas ópticas o un fotón en una guía de ondas. Un cúbit lógico, en contraposición, es un estado cuántico abstracto y protegido, cuya estabilidad procede del comportamiento coordinado de una amplia red de cúbits físicos.
La equivalencia dista mucho de ser de uno a uno.
En un diseño habitual de código de superficie rotado, el volumen de cúbits físicos (tanto de datos como de síndrome) escala aproximadamente con el cuadrado de la distancia del código (d²). Para ejecutar aplicaciones de alto impacto criptográfico, como romper el cifrado RSA mediante el algoritmo de Shor, se requieren distancias de código de hasta d=27 o d=31 con tasas de fallo prácticamente nulas. Aunque una mayor distancia proporciona este aislamiento extremo, exige un peaje monumental en hardware.
Por esta razón se menciona con frecuencia la proporción de 1.000 cúbits físicos por cada cúbit lógico en las hojas de ruta del sector. Este cálculo no representa una ley invariable de la física, sino un orden de magnitud realista cuando se contemplan distancias de código funcionales, extracción de síndromes continua, enrutamiento espacial, mitigación de fugas, margen para cúbits de reserva y el coste asociado a las puertas lógicas tolerantes a fallos.
Esa proporción puede variar sustancialmente según el código corrector y la arquitectura de hardware empleada. Por ejemplo, los códigos cuánticos de comprobación de paridad de baja densidad (qLDPC) son objeto de intensas investigaciones precisamente porque admiten tasas de codificación mucho más eficientes que los códigos de superficie planos, si bien exigen una conectividad no local y decodificadores mucho más complejos. Las plataformas de átomos neutros ofrecen un potencial notable en este campo, ya que las matrices reconfigurables mediante láser permiten interacciones a distancia inviables en los procesadores bidimensionales fijos.
A esto se suma un coste adicional con el que no siempre se cuenta: no todos los cúbits lógicos tienen el mismo peso computacional. Una máquina cuántica útil demanda puertas lógicas universales, mediciones sin destrucción, desplazamiento de información y fábricas dedicadas a la destilación de «estados mágicos» para ejecutar operaciones no pertenecientes al grupo de Clifford.
El sistema, por tanto, no se limita a transformar «1.000 cúbits ruidosos en 1 cúbit limpio», sino que debe vertebrar toda una pila de computación protegida a su alrededor.
Hitos actuales y la senda hacia la tolerancia a fallos comercial
La computación cuántica ha dejado atrás su fase puramente teórica: la corrección de errores cuánticos se ha transformado formalmente en una disciplina de ingeniería experimental. La cuestión decisiva hoy en día es dilucidar si las demostraciones de laboratorio podrán escalarse hasta formar máquinas capaces de ejecutar algoritmos complejos durante el tiempo necesario para compensar su tremendo coste físico.
Equipos punteros como Google Quantum AI han demostrado el escalado de memorias lógicas por debajo del umbral de error con procesadores superconductores, logrando consolidar memorias cuánticas con una distancia de código d=7 a partir de 101 cúbits físicos. Trabajos posteriores han demostrado una mayor estabilidad lógica sostenida, alcanzando tasas de error por ciclo inferiores a 10-3 en condiciones de prueba controladas. Aunque son avances de primer orden en decodificación, reducción de derivas de calibración y corrección activa, todavía no equivalen a un ordenador cuántico universal tolerante a fallos.
Por su parte, IBM avanza combinando escalado de hardware modular, optimización de interconexiones y esquemas qLDPC orientados a la tolerancia a fallos. Su hoja de ruta oficial sitúa el despliegue de decodificación de errores en tiempo real en torno a 2026, con la meta de presentar su primer sistema formalmente tolerante a fallos, Starling, hacia 2029. Conviene subrayar que estos plazos representan proyecciones estratégicas de la propia compañía y pueden variar según madure la tecnología.
Las plataformas de átomos neutros avanzan con paso firme en una trayectoria complementaria. Diversos grupos experimentales han demostrado ciclos reiterados de corrección en códigos de superficie, entrelazamiento lógico, reutilización de cúbits en vuelo y operaciones lógicas transversales mediante matrices dinámicas de pinzas ópticas. Investigaciones recientes publicadas en Nature han recurrido a cientos de átomos neutros para explorar regímenes por debajo del umbral, entrelazamiento lógico multicúbit y compuertas universales mediante teletransporte cuántico.
En este panorama, el verdadero termómetro científico no es el recuento bruto de cúbits físicos en un titular de prensa, sino el punto de rentabilidad cuántica (break-even point). Un procesador alcanza este punto crítico cuando el cúbit lógico codificado logra sobrevivir durante más tiempo —o realizar operaciones con menor tasa de error— que el mejor cúbit físico individual sin codificar disponible en esa misma máquina. Este hito se ha alcanzado ya en varias arquitecturas pioneras, como los sistemas basados en cavidades superconductoras y los procesadores de átomos neutros, marcando el inicio de la era práctica de la computación cuántica.
Preguntas frecuentes sobre la corrección de errores cuánticos
¿Por qué no sirven los métodos de corrección de errores tradicionales en los ordenadores cuánticos?
La informática clásica se basa en la clonación de datos (por ejemplo, mediante códigos de repetición) y en comprobaciones directas de paridad. Este enfoque es inviable en la física cuántica por dos motivos determinantes: el teorema de no clonación prohíbe de manera estricta replicar un estado cuántico desconocido, y la medición directa colapsa la función de onda de la superposición, destruyendo de inmediato los datos procesados en el cálculo.
¿Por qué un cúbit lógico necesita aproximadamente 1.000 cúbits físicos?
Para ejecutar circuitos cuánticos profundos y útiles, la probabilidad de error lógico debe reducirse drásticamente (a menudo por debajo de 10-12). En los códigos de superficie bidimensionales, la cantidad de cúbits físicos escala con el cuadrado de la distancia del código (d²). Al computar los cúbits de datos, los cúbits auxiliares para síndromes, las rutas de interconexión y los módulos auxiliares de destilación de estados mágicos, las arquitecturas viables necesitan entre cientos y miles de cúbits físicos para sostener un solo cúbit lógico funcional.
¿Qué significa el «break-even point» o punto de rentabilidad en la corrección de errores cuánticos?
El «break-even point» es el hito experimental donde un cúbit lógico codificado demuestra un tiempo de coherencia superior y una tasa de error inferior a los del mejor cúbit físico individual sin codificar presente en el hardware. Superar este umbral certifica que los beneficios aportados por la corrección de errores cuánticos compensan con creces el ruido intrínseco añadido por los componentes adicionales y los circuitos auxiliares de medición.
Contacta con nosotros
 (+86) 177 3001 9472
 market@originqc.com